
Most csak idemásoltam egy privát válaszomat egy 6x RTX 3090 AI rig építése kapcsán, ahol azt érzékeltem, hogy a GPU-k bekötési topológiájának kapcsán még hiányzik némi alaptudás.
Tehát...
Az RTX 3090 PCIe gen 4.0-t támogat.
Mivel az általad választott alaplap csak PCIe 3.0-t támogat, ezért Tensor Parallel AI futtatáshoz (és traininghez is) szükséged lesz lehetőleg mind a 16 PCIe lane-re minden slotban.
Az a riser, amit kinéztél, a 16-ból cak egyetlen 1 sávot köt össze!!
Ez a típus NEM VALÓ AI-hoz, mert x1 PCIe kapcsolatot létesít csak.

Milyen risert használj akkor, ami kihasználja a PCIe sávokat....?
1. szalagkábeles riser - ez létezik x16 és x8 és x4 kivitelben is
2. slimsas kábeles riser, ami x8 és x16 is lehet (egy slimsas kábel x8-at visz át)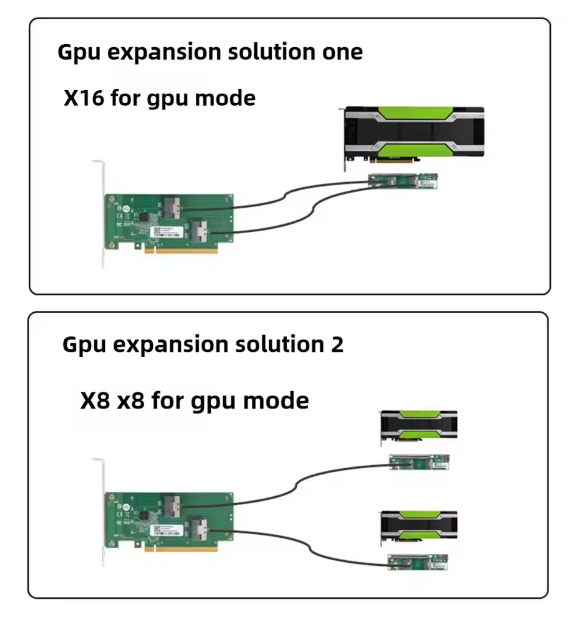
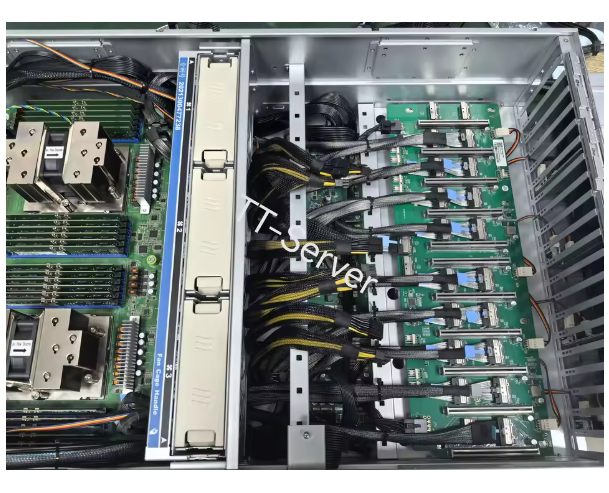
3. riser board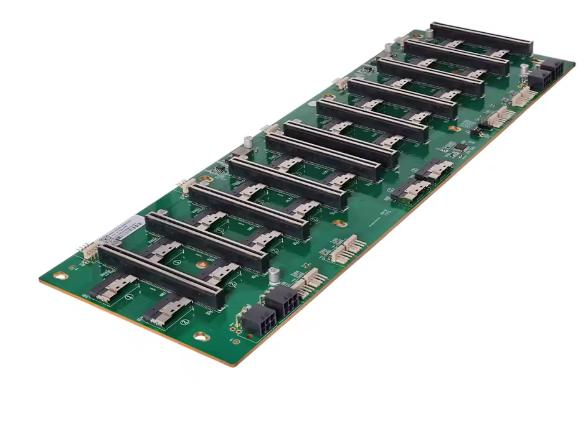
4. PCIe switch - ez egy külön témakör, ebbe most nem megyek bele részletesen, de sokan nem ismerik és nagyon sok olyan szituáció van, amikor EZ A LEGJOBB megoldás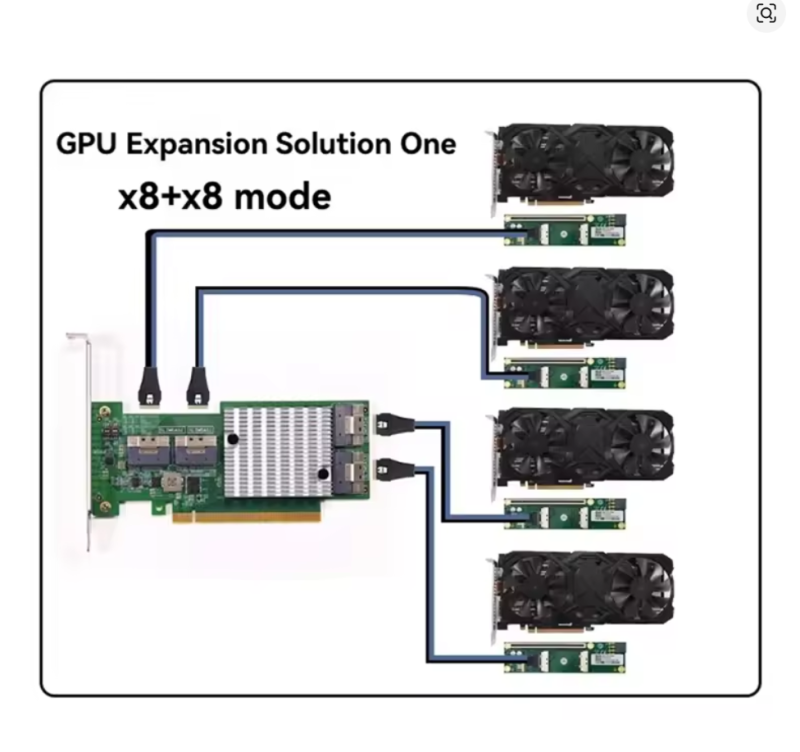
És van még ott, ahonnan ez jött...
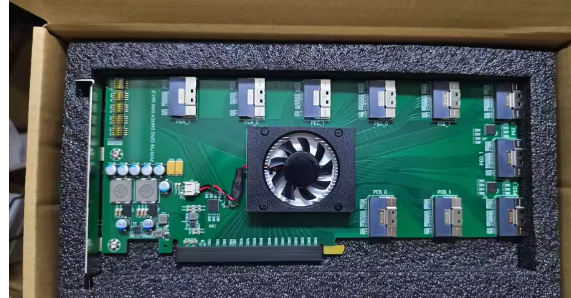
Ez pl kombinálhaó a fenti 10 slotos riser boarddal és akkor akár
EGYETLEN x16 PCIe slotra beköthetsz 10db GPU-t is!
A switchek egy külön cikket érdemelnének, mivel pl TP LLM inference esetén általában jobb decode sebességet eredményeznek, mint egy többezer Euros sok slotos sok processzoros szerverbe helyezve.
A varázsszó itt a latency és nem is feltétlen a sávszél. És ebben a switchek SOKKAL jobbak a natív PCIe sávoknál!
Ha a P2P DMA-t bekapcsolod a kártyákon, akkor ez azt jelenti, hogy a GPU-k közötti kommunikáció, (ami pl TP inference esetén elsődleges) DIREKTBEN történik a switchen keresztül és nem kolbászol a CPU felé, ahol semmi keresnivalója!
Lehet, hogy folyt köv...


